Come funziona un modello AI: la guida per capire come pensa l'AI
Transformer, token, training, allucinazioni. Dietro ogni risposta di ChatGPT o Claude c'è un meccanismo preciso. Capirlo cambia il modo in cui usi questi strumenti.
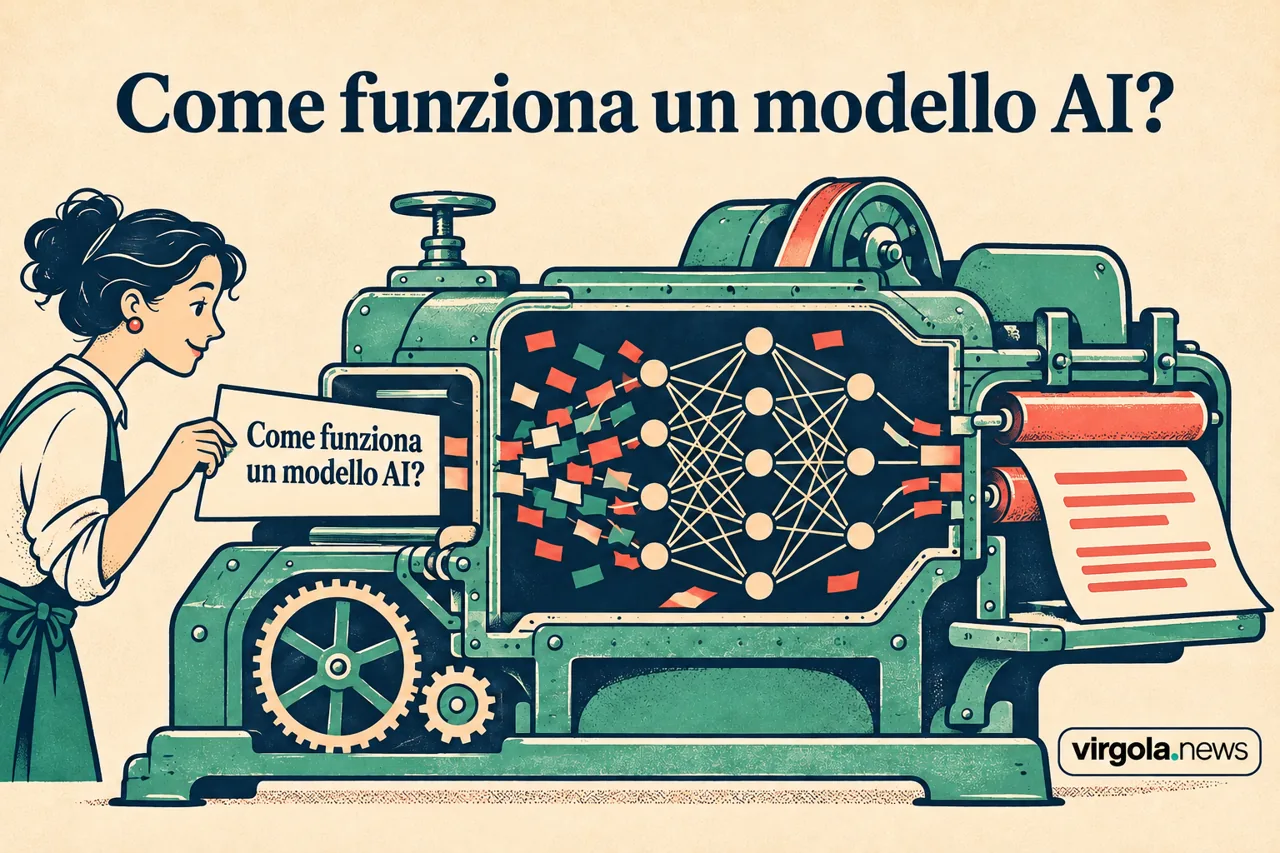
Ogni giorno milioni di persone scrivono a ChatGPT, a Claude, a Gemini. Chiedono spiegazioni, fanno correggere testi, cercano idee, delegano compiti. E quasi nessuna di queste persone sa cosa succede nel momento in cui preme invio.
Non è un problema, non serve capire come funziona un motore per guidare. Ma c'è una differenza tra guidare e guidare bene: chi capisce cosa c'è sotto il cofano sa come usare lo strumento nei casi difficili, sa fino a che punto si può spingere, sa interpretare i segnali prima che qualcosa vada storto.
Con l'AI è lo stesso, capire come funziona un modello linguistico non è un esercizio accademico. È la base per usarlo in modo più consapevole, più efficace, e con aspettative realistiche.
Questa guida non richiede background tecnico. Non troverai formule matematiche né codice. Troverai spiegazioni precise, qualche analogia, e una serie di concetti che, una volta capiti, cambiano il modo in cui guardi questi strumenti ed interagisci con loro.
In questa guida
- 01Prima cosa: demolire tre miti
- 02Il training: come nasce un modello
- 03RLHF: come si insegna al modello a rispondere bene
- 04I token: come il modello legge il testo
- 05L'architettura transformer: cosa c'è dentro
- 06Come il modello genera una risposta
- 07Le allucinazioni: perché l'AI inventa
- 08Parametri e dimensioni: cosa significa disporre di un modello grande
- 09Memoria, contesto e cosa il modello ricorda
- 10Ragionamento e agenti
- 11FAQ
- 12Conclusione
Prima cosa: demolire tre miti
Prima di spiegare come funziona un modello AI, vale la pena rimuovere tre idee sbagliate che quasi tutti portano con sé. Non perché siano stupide, ma perché interferiscono con la comprensione di quello che viene dopo.
Il primo mito è che l'AI “pensi” nel senso in cui pensiamo noi. Non è così. Un modello linguistico non ha esperienze, non ha intenzioni, non ha una visione del mondo. Ha pattern. Miliardi di relazioni statistiche tra parole, frasi, concetti. Quello che produce somiglia al pensiero perché è stato addestrato su testo prodotto da persone che pensano. Ma il processo sottostante è radicalmente diverso.
Il secondo mito è che l'AI “cerchi” le risposte da qualche parte, come farebbe un motore di ricerca. In realtà un modello linguistico genera testo in tempo reale, parola dopo parola, in base a quello che ha appreso durante il training. Non consulta un database di risposte corrette. Costruisce la risposta nel momento in cui la produce.
Il terzo mito è che i modelli più grandi siano semplicemente “più intelligenti” in senso assoluto. La realtà è più sfumata: modelli diversi hanno punti di forza diversi, e la dimensione è solo uno dei fattori che influenzano la qualità delle risposte.
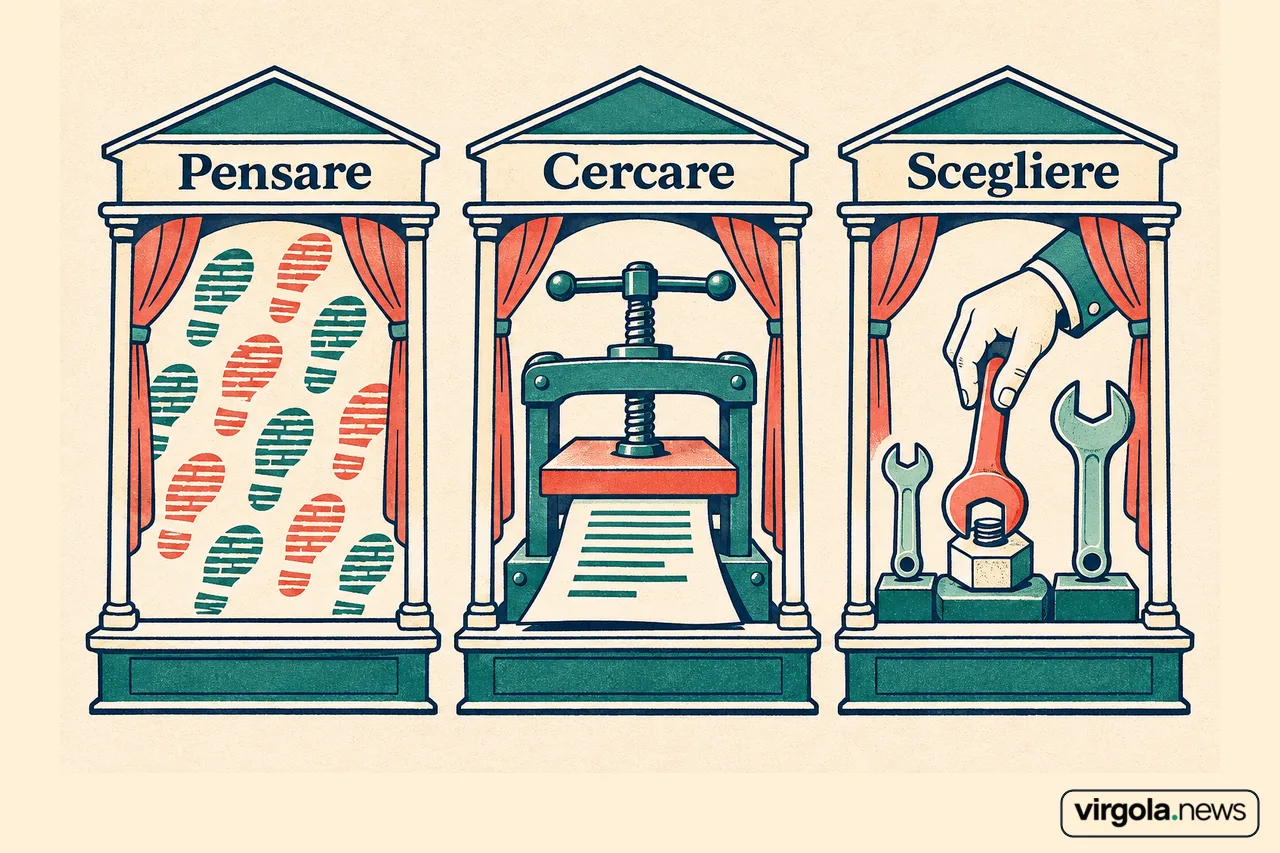
Tenere a mente questi tre punti rende tutto quello che segue molto più comprensibile. L'AI non pensa, non cerca, e "più grande" non significa sempre "meglio per te".
Il training: come nasce un modello
Tutto inizia con i dati. Una quantità di testo che è difficile anche solo da immaginare: libri, articoli, forum, pagine web, codice, conversazioni, documentazione tecnica, letteratura. Miliardi e miliardi di parole in decine di lingue.
Questo testo viene usato per addestrare il modello attraverso un processo chiamato pre-training. Il meccanismo è, nella sua essenza, sorprendentemente semplice: al modello viene mostrata una sequenza di testo con una parola nascosta, e il suo compito è indovinare quella parola. Se sbaglia, viene corretto. Se azzecca, viene rinforzato. Questo processo si ripete miliardi di volte.
Sembra banale. Ma il risultato non lo è. Per indovinare sistematicamente la parola mancante in miliardi di contesti diversi, il modello è costretto a sviluppare una comprensione implicita della grammatica, del significato, della logica, dei fatti, delle relazioni tra concetti. Non perché qualcuno gliel'abbia insegnato esplicitamente, ma perché è l'unico modo per fare bene quel compito su quella scala.
Pensa a un bambino che impara a leggere: nessuno gli spiega le regole della grammatica italiana prima che sappia leggere. Le acquisisce implicitamente, attraverso l'esposizione a migliaia di esempi. Il training di un modello funziona secondo una logica analoga, ma a una scala incomparabilmente più grande e in un tempo molto più compresso.
Il pre-training produce un modello che sa completare testo in modo coerente. Ma non è ancora un assistente utile: risponde in modo imprevedibile, può generare contenuti inappropriati, non segue istruzioni in modo affidabile.
Per trasformarlo in qualcosa di usabile entra in gioco una seconda fase, il fine-tuning, in cui il modello viene ulteriormente addestrato su esempi di conversazioni di alta qualità. E poi una terza fase che ha rivoluzionato il settore.
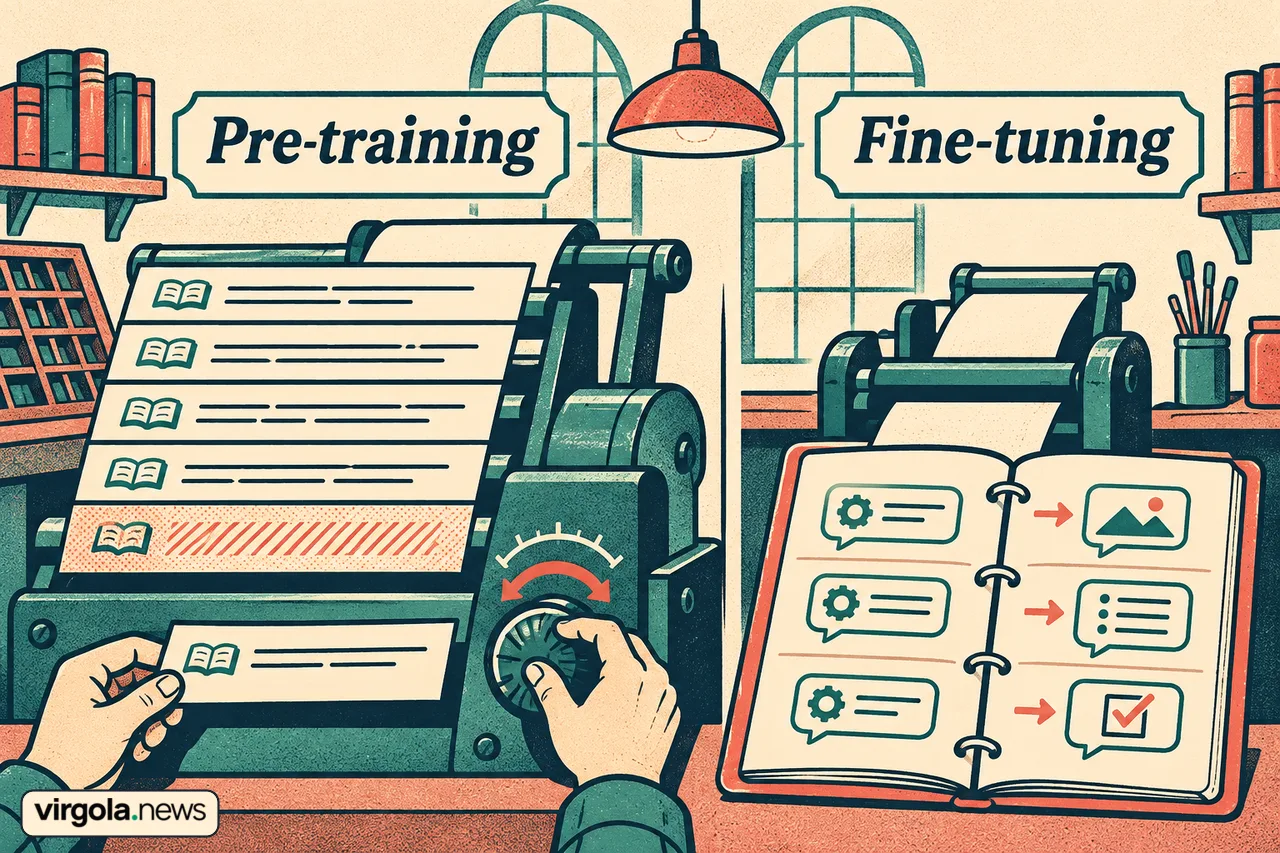
Il pre-training dura settimane o mesi, costa decine di milioni di dollari in potenza di calcolo, e viene fatto una volta sola. Il modello che usi oggi è il risultato di quell'investimento, congelato in un punto preciso del tempo.
RLHF: come si insegna al modello a rispondere bene
La terza fase del training si chiama RLHF, sigla per Reinforcement Learning from Human Feedback. È la tecnica che ha trasformato i modelli da completatori di testo a assistenti conversazionali, ed è quella che più di ogni altra ha determinato il comportamento dei modelli che usiamo oggi.
Il processo funziona così: ai modelli vengono mostrate due risposte diverse alla stessa domanda, e degli esseri umani indicano quale delle due è migliore. Il modello impara, iterazione dopo iterazione, a produrre risposte che gli esseri umani preferiscono: più utili, più accurate, più sicure, più naturali.
L'RLHF ha avuto effetti enormi. Ha reso i modelli molto più efficienti, molto più sicuri nell'evitare contenuti dannosi, e molto più piacevoli da usare. Ha anche introdotto alcune caratteristiche che a volte diventano limitazioni: i modelli tendono a essere eccessivamente cauti, a rispondere in modo diplomatico anche quando una posizione netta sarebbe più utile, e a confezionare le risposte in un formato rassicurante anche quando il formato non è quello giusto.
Capire che questi comportamenti vengono dall'addestramento su preferenze umane aiuta a spiegarli, e a capire come aggirarli quando necessario.
I token: come il modello legge il testo
Prima di spiegare come il modello genera testo, bisogna capire come lo legge. E la risposta è: non lo legge come facciamo noi, parola per parola. Lo legge suddiviso in token.
Un token è un'unità di testo che può essere una parola intera, una parte di parola, o anche un singolo carattere. In inglese, la maggior parte delle parole comuni corrisponde a un token. In italiano e nelle altre lingue romanze, le cose si complicano: le parole più lunghe vengono spesso divise in due o più token. La parola “straordinariamente”, per esempio, potrebbe essere divisa in tre o quattro token.
Perché importa? Per diverse ragioni pratiche.
Prima di tutto, i modelli hanno una finestra di contesto misurata in token. Se il tuo modello ha una finestra da 128.000 token, non puoi dargli un testo arbitrariamente lungo. E le lingue diverse hanno densità di token diverse per lo stesso contenuto: un testo in italiano o tedesco “pesa” di più in token dello stesso testo in inglese.
In secondo luogo, il modello non “vede” le parole. Vede sequenze di numeri che rappresentano i token. Prima di processare il tuo prompt, tutto il testo viene convertito in una sequenza numerica. Dopo che il modello genera i token della risposta, questi vengono riconvertiti in testo. Il testo che leggi è il risultato di questa operazione di decodifica.
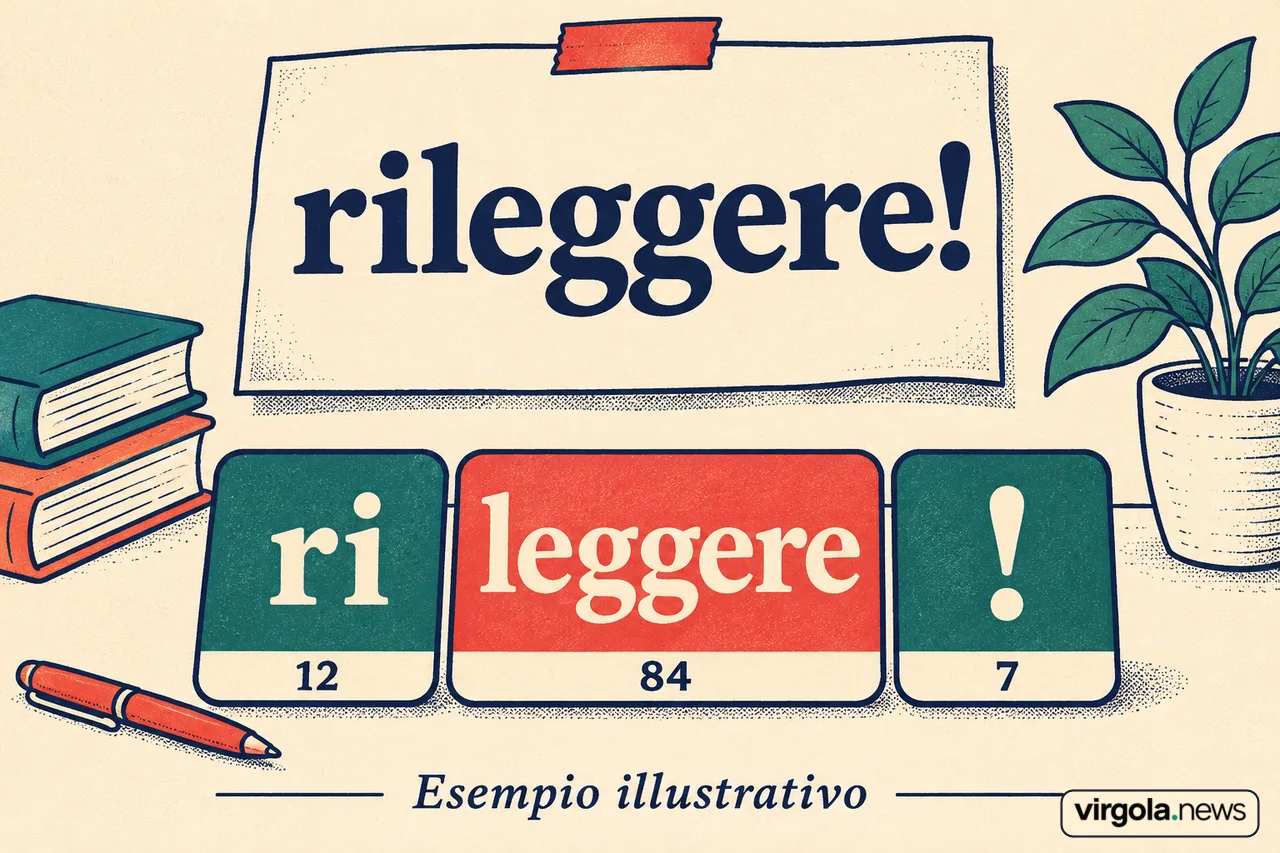
Puoi stimare approssimativamente: 100 parole italiane corrispondono a circa 150 token. Tienilo a mente quando lavori con testi lunghi e hai vincoli di lunghezza.
L'architettura transformer: cosa c'è dentro
Nel 2017, un paper pubblicato da ricercatori di Google con il titolo “Attention Is All You Need” ha introdotto l'architettura transformer. Da quel momento, quasi ogni avanzamento importante nel campo dei modelli linguistici si è basato su questa architettura. ChatGPT, Claude, Gemini, LLaMA: sono tutti transformer.
Cosa rende il transformer così speciale? La risposta sta in un meccanismo chiamato self-attention, che è il cuore dell'architettura.
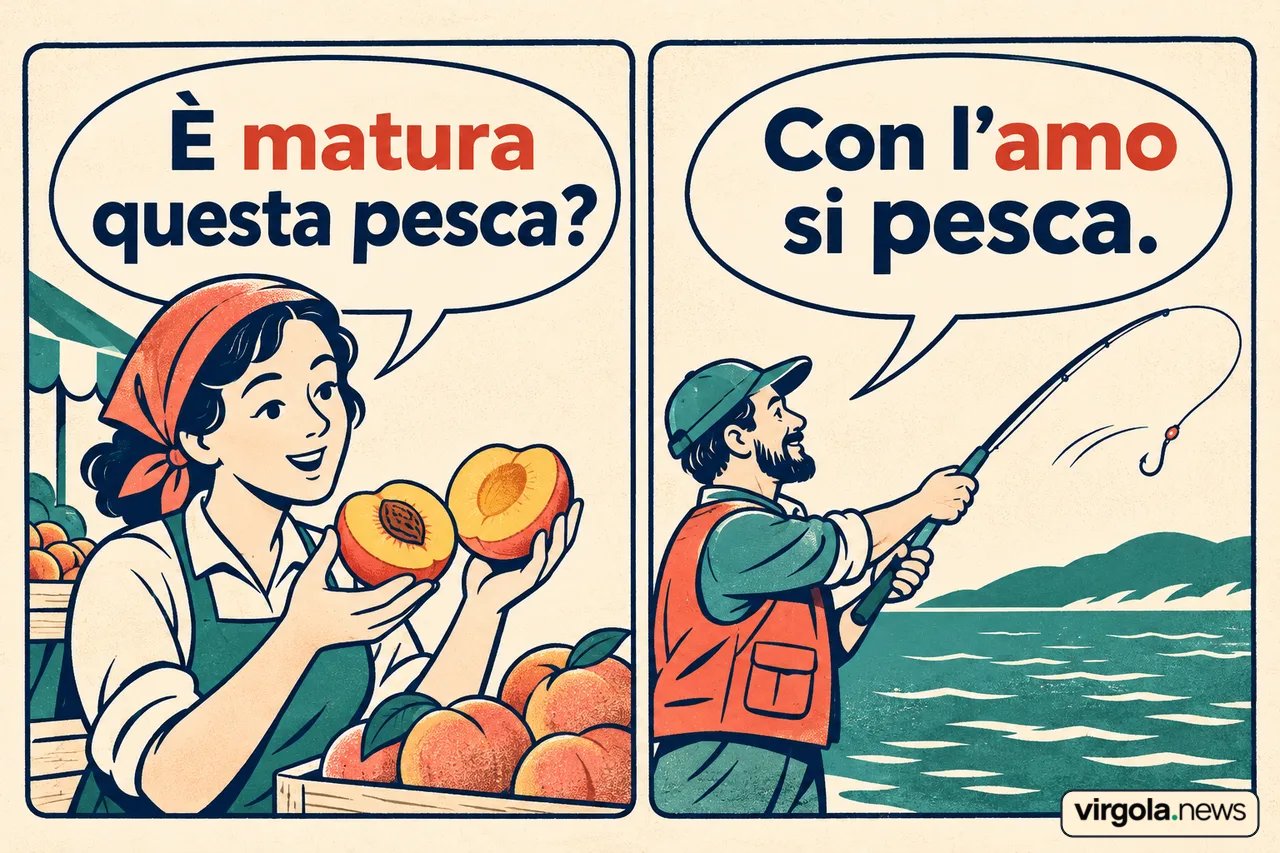
Immagina di leggere questa frase: “La banca sul fiume aveva le sponde ripide.” La parola “banca” è ambigua: potrebbe essere un istituto finanziario o la riva di un fiume. Come capisce un essere umano qual è il significato giusto? Guardando il contesto: “fiume”, “sponde”, “ripide” indicano chiaramente che si parla di morfologia fluviale.
Il meccanismo di self-attention permette al modello di fare esattamente questo: per ogni token che sta processando, calcola quanto “attenzione” dare a ogni altro token nella sequenza. Non in modo uguale per tutti, ma in modo pesato: i token rilevanti ricevono più attenzione, quelli irrilevanti meno.
Questo meccanismo viene eseguito in parallelo su milioni di esempi durante il training, e il modello impara quali relazioni tra token sono importanti per comprendere il significato. Il risultato è un sistema che riesce a catturare dipendenze a lunga distanza nel testo, a disambiguare parole polisemiche in base al contesto, e a tenere traccia di relazioni complesse tra concetti.
Il transformer non è l'unica architettura possibile, ma ha dimostrato di scalare in modo eccezionale: più dati, più potenza di calcolo, più parametri, e le performance continuano a migliorare in modo prevedibile. Questo comportamento di “scaling” ha guidato gli investimenti enormi che hanno portato ai modelli che esistono oggi.
Come il modello genera una risposta
Arriviamo al momento chiave: cosa succede esattamente quando il modello genera una risposta?
Il processo si chiama inferenza, e funziona token per token. Dato il testo in input (il tuo prompt, più la storia della conversazione), il modello calcola una distribuzione di probabilità su tutti i token possibili del suo vocabolario. Poi ne sceglie uno. Poi aggiunge quel token all'input, ricalcola la distribuzione, ne sceglie un altro. E così via, fino a quando non genera un token speciale che segnala la fine della risposta.
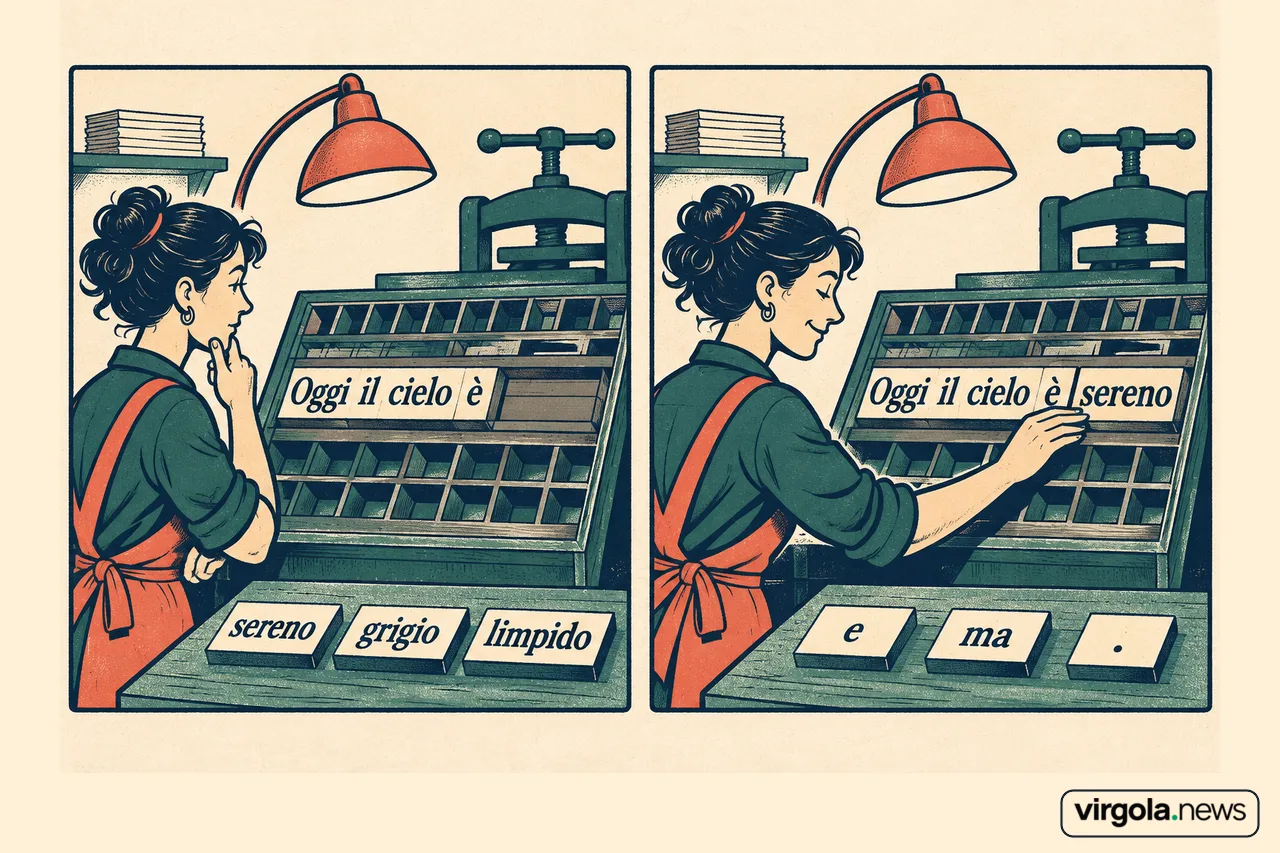
“Distribuzione di probabilità” significa che il modello non dice “la parola successiva è X”. Dice “la parola successiva potrebbe essere X con il 42% di probabilità, Y con il 28%, Z con il 15%...” e poi sceglie. Come sceglie dipende da un parametro chiamato temperatura.
Con una temperatura bassa, il modello sceglie quasi sempre il token più probabile: le risposte sono coerenti e prevedibili, ma tendono alla ripetitività. Con una temperatura alta, il modello sceglie più spesso tra le opzioni meno probabili: le risposte sono più creative e varie, ma anche meno stabili. I servizi che usiamo normalmente operano a temperature intermediate, calibrate per l'uso pratico.
C'è una conseguenza importante di questo meccanismo: il modello non “sa” cosa dirà prima di dirlo. Genera la risposta in tempo reale, un token alla volta, senza avere una visione anticipata del risultato finale. Questo spiega perché a volte una risposta inizia in modo diverso da come finisce, o perché il modello può contraddirsi nel corso di una risposta lunga.
Le allucinazioni: perché l'AI inventa
Le allucinazioni sono forse il fenomeno più frainteso dei modelli linguistici. Il termine suona come un difetto tecnico da risolvere, qualcosa che verrà eliminato con la versione successiva. In realtà è una conseguenza strutturale del modo in cui questi modelli funzionano, e capirla cambia il modo in cui ci si rapporta allo strumento.
Ricorda: il modello genera testo scegliendo il token statisticamente più plausibile dato il contesto. Non ha accesso a un oracolo della verità. Non sa cosa è vero e cosa non lo è. Sa quali sequenze di testo sono plausibili in base a quello che ha visto durante il training.
Quando il modello viene interrogato su qualcosa che non ha "visto" abbastanza durante il training, o su qualcosa che richiede ragionamenti precisi su fatti specifici, può generare testo che suona corretto e autorevole ma che è semplicemente sbagliato. Non “mente” nel senso morale del termine. Genera la sequenza più plausibile, e quella sequenza può capitare che sia falsa.
Le allucinazioni sono più probabili in certi contesti: fatti molto specifici (date, numeri, nomi), domini molto specializzati, ragionamenti quantitativi, eventi recenti non coperti dal training data. Sono meno probabili su argomenti generali, ampiamente documentati, che il modello ha visto da mille angolazioni diverse durante il training.
Non trattare mai il modello come una fonte primaria su fatti verificabili. Usalo per ragionare, strutturare, riscrivere, sintetizzare. Per i fatti, verifica sempre su fonti attendibili.
Le soluzioni che i laboratori di AI stanno sviluppando, come il grounding (ancorare le risposte a documenti specifici) e il tool use (permettere al modello di cercare informazioni in tempo reale), riducono le allucinazioni in certi contesti ma non le eliminano completamente. Rimane fondamentale capire quando fidarsi e quando verificare.
Parametri e dimensioni: cosa significa disporre di un modello grande
Quando si parla di modelli AI, si sente spesso citare il numero di parametri: GPT-4 ha centinaia di miliardi di parametri, LLaMA 3 ne ha versioni da 8 a 405 miliardi. Cosa sono questi parametri?
I parametri sono i numeri che definiscono il comportamento del modello. Durante il training, vengono aggiustati miliardi di volte finché il modello non impara a fare previsioni accurate. Alla fine del training, questi numeri restano fissi: sono il modello. Tutti i miliardi di parole viste durante l'addestramento sono stati compressi in quei parametri.
Più parametri significano generalmente più capacità di memorizzare e relazionare concetti, più sfumatura nelle risposte, migliore ragionamento su problemi complessi. Ma la relazione non è lineare: un modello più piccolo addestrato su dati migliori può superare un modello più grande addestrato su dati di qualità inferiore.
Negli ultimi anni c'è stata anche una revisione importante di questo paradigma: tecniche come la distillazione e il quantization permettono di comprimere modelli molto grandi in versioni più piccole che mantengono gran parte delle capacità originali con una frazione del costo computazionale. I modelli che girano su dispositivi locali oggi hanno performance che solo due anni fa erano impensabili per quelle dimensioni.
| Dimensione | Uso tipico | Esempio |
|---|---|---|
| Meno di 10 miliardi di parametri | Dispositivi locali, task specializzati | LLaMA 3 8B, Gemma 2 |
| 10-70 miliardi | Bilanciamento capacità/costo, cloud economico | LLaMA 3 70B, Mistral |
| Oltre 100 miliardi | Ragionamento complesso, uso professionale | GPT-4, Claude Opus, Gemini Ultra |
Memoria, contesto e cosa il modello ricorda
Uno degli aspetti più controintuitivi dei modelli linguistici è il loro rapporto con la memoria. Nella vita quotidiana, uno strumento che hai usato ieri “ricorda” come ti comportavi. Un modello AI, nella sua forma base, no.
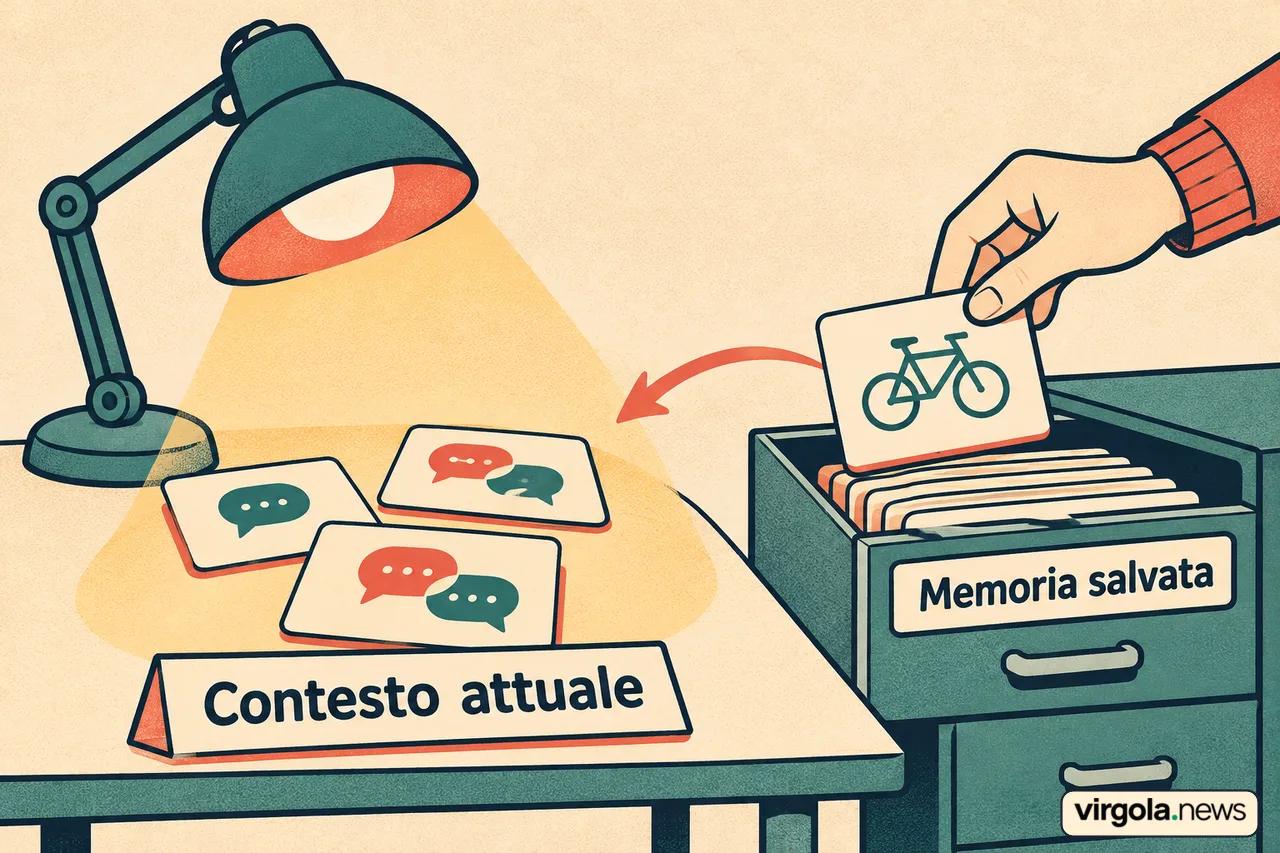
Ogni conversazione inizia da zero. Il modello non ha memoria persistente tra sessioni diverse a meno che non sia stata implementata esplicitamente dal servizio che stai usando. Quello che “ricorda” nel corso di una conversazione è solo quello che si trova nella finestra di contesto attuale: tutto il testo scambiato fino a quel momento.
Questo ha implicazioni pratiche importanti. Se riapri una chat dopo giorni, il modello non sa chi sei, non ricorda cosa avete detto, non ha continuità con le conversazioni precedenti. La “personalità” coerente che percepisci è il risultato dell'addestramento generale, non di una memoria costruita nel tempo sulla tua persona.
Le funzioni di memoria che alcuni servizi offrono (ChatGPT Memory, per esempio) sono implementazioni esterne: salvano informazioni in un database e le iniettano nel contesto all'inizio di ogni conversazione. Non è memoria nel senso biologico. È un trucco utile, ma è importante capire la differenza.
La finestra di contesto è diventata sempre più grande negli ultimi anni. I modelli moderni gestiscono centinaia di migliaia di token, e alcuni arrivano a un milione. Questo permette di lavorare con documenti interi, conversazioni molto lunghe, basi di codice estese. Tuttavia più la finestra è piena, più il modello può avere difficoltà a mantenere alta attenzione su tutte le parti del contesto in modo uniforme: i contenuti agli estremi della finestra (all'inizio e alla fine) tendono a ricevere più attenzione di quelli nel mezzo.
Ragionamento e agenti
I modelli che abbiamo descritto finora sono fondamentalmente sistemi di completamento del testo molto sofisticati. Ma il panorama si sta evolvendo rapidamente, e due sviluppi in particolare stanno cambiando quello che questi sistemi possono fare.
Il primo è il ragionamento esteso. Modelli come o3 di OpenAI e Claude 3.7 Sonnet possono dedicare più tempo a “pensare” prima di rispondere, generando catene di ragionamento interne che portano a risposte molto più accurate su problemi complessi. Non è ancora ragionamento nel senso umano, ma produce risultati qualitativamente diversi rispetto alla generazione diretta di testo.
Il secondo sviluppo sono gli agenti AI. Un agente non si limita a rispondere: può usare strumenti (cercare sul web, eseguire codice, leggere file, chiamare API), pianificare sequenze di azioni, e portare a termine task complessi in modo autonomo. La differenza tra un assistente che risponde a domande e un agente che esegue compiti è sostanziale, e rappresenta il passo evolutivo su cui i principali laboratori di ricerca stanno concentrando i propri sforzi.
Capire i fondamentali che abbiamo visto in questa guida diventa ancora più importante in questo contesto: un agente che ha allucinazioni durante un'operazione critica non produce solo una risposta sbagliata, ma può compiere azioni sbagliate con conseguenze reali.
FAQ
L'AI capisce davvero quello che dico?
I modelli AI continuano a imparare dalle nostre conversazioni?
Perché lo stesso prompt dà risposte diverse ogni volta?
Un modello AI può ragionare su cose che non ha mai visto nel training?
Tutti i modelli AI funzionano nello stesso modo?
Conclusione
Siamo partiti da una domanda semplice e siamo arrivati fino al cuore di come funzionano i sistemi tecnologici più influenti del momento. Non c'è stata matematica, non c'è stato codice. Solo meccanismi, e il senso di quello che producono.
Quello che hai letto non è la storia completa. I dettagli tecnici sono infinitamente più complessi, e il campo si muove così veloce che alcune delle cose che abbiamo descritto potrebbero essere parzialmente superate nei prossimi anni. Ma i concetti fondamentali restano stabili: il training su grandi quantità di testo, i token, l'attenzione, la generazione probabilistica, le allucinazioni come conseguenza strutturale.
La cosa più importante che puoi portare via da questa guida è la consapevolezza che stai usando uno strumento con caratteristiche precise. Non è un oracolo, non è una persona, non è un motore di ricerca. È un sistema statistico molto sofisticato, addestrato a produrre testo plausibile, guidato da feedback umano a produrre testo utile.
Sapere questo ti rende un utente migliore. Ti fa fare le domande giuste, interpretare le risposte con la giusta dose di fiducia e di critica, e riconoscere i casi in cui lo strumento è eccellente da quelli in cui è inaffidabile. In un momento in cui questi strumenti stanno entrando in ogni aspetto del lavoro e della vita quotidiana, questa consapevolezza vale più di qualsiasi trick o scorciatoia.
Se vuoi approfondire come usare al meglio questi modelli ora che sai come funzionano, la guida sul prompt engineering è il passo successivo naturale.
Potrebbe interessarti
Google rende più facile riprendere le ricerche di AI Mode dalla homepage
La barra laterale è in distribuzione globale su desktop e avvicina l’esperienza a quella di ChatGPT e Claude
Modelli AI·20 novembre 2026, 16:02Abbiamo veramente il controllo dei nostri agenti AI?
Editoriale·20 novembre 2026, 14:01Apple lavora a un agente AI a cui delegare compiti tra app e computer
Il progetto prevede accessi controllati e ambienti isolati per eseguire codice e agire per conto dell’utente
Modelli AI·20 novembre 2026, 11:10Un agente OpenAI crea uno script per spiare delle email, il suo compito era di scrivere un documento
È successo durante l’addestramento di un modello interno: gli script non sono stati eseguiti e nessuna email è partita
Modelli AI·20 novembre 2026, 08:56Siri Recap prende appunti al posto nostro, ma rinunciare alla nostra privacy vale questa comodità?
La beta per Apple Watch permette di programmare l’ascolto trasformando conversazioni in titoli e punti chiave
Strumenti & App·19 novembre 2026, 17:06Google lancia il nuovo modello Gemini 4 Neon: il costo per token raddoppia
Il nuovo modello di Google è secondo nel Vals Index: per scegliere conta anche la spesa per completare un compito
Modelli AI·19 novembre 2026, 08:46La proposta italiana sui social lega l’accesso degli under 16 ai genitori
Sotto i 13 anni scatterebbe il divieto; dai 13 alla soglia dei 16 servirebbe un profilo collegato a un genitore
Società·18 novembre 2026, 09:52
